Domain rvvn.de kaufen?
Wir ziehen mit dem Projekt
rvvn.de um.
Sind Sie am Kauf der Domain
rvvn.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain rvvn.de kaufen?
Wie beeinflusst das Crawling von Suchmaschinen die Sichtbarkeit einer Website im Internet?
Das Crawling von Suchmaschinen ermöglicht es, dass die Inhalte einer Website indexiert werden und in den Suchergebnissen erscheinen. Je häufiger eine Website gecrawlt wird, desto schneller werden neue Inhalte entdeckt und in den Suchergebnissen angezeigt. Eine regelmäßige Optimierung der Website für Suchmaschinen kann die Sichtbarkeit und das Ranking in den Suchergebnissen verbessern. **
Was sind die Vor- und Nachteile von Web-Crawling für die Datensammlung im Internet?
Vorteile: Web-Crawling ermöglicht eine schnelle und automatisierte Datensammlung im Internet, was Zeit und Ressourcen spart. Es können große Mengen an Daten in kurzer Zeit gesammelt werden. Nachteile: Es kann zu rechtlichen Problemen kommen, da nicht alle Websites das Crawlen ihrer Daten erlauben. Zudem können veraltete oder ungenaue Informationen gesammelt werden, da Web-Crawler nicht immer die aktuellsten Daten liefern. Schließlich kann die Qualität der gesammelten Daten aufgrund von Fehlern im Crawling-Prozess beeinträchtigt werden. **

Ähnliche Suchbegriffe für Wyrd---Crawling-Chaos
Top-Angebote
Produkte zum Begriff Wyrd---Crawling-Chaos:


-
Wie können Web-Crawling-Technologien genutzt werden, um Informationen aus dem Internet zu extrahieren und zu analysieren? Welche Vorteile bietet Web-Crawling bei der Sammlung von Daten aus dem World Wide Web?
Web-Crawling-Technologien durchsuchen automatisch das Internet nach relevanten Informationen, extrahieren diese und speichern sie in einer Datenbank. Durch die kontinuierliche Aktualisierung der gesammelten Daten können Trends und Muster identifiziert und analysiert werden. Dies ermöglicht Unternehmen, fundierte Entscheidungen auf der Grundlage aktueller Informationen zu treffen und Wettbewerbsvorteile zu erlangen. **
-
Was sind die Unterschiede zwischen Web-Crawling und Daten-Crawling und wie werden sie in der Datenanalyse eingesetzt?
Web-Crawling bezieht sich auf das Durchsuchen von Websites im Internet, um Informationen zu sammeln, während Daten-Crawling sich auf das Durchsuchen von strukturierten Datenquellen wie Datenbanken oder APIs bezieht. In der Datenanalyse werden Web-Crawling und Daten-Crawling eingesetzt, um relevante Daten zu sammeln und zu extrahieren, die dann für die Analyse und Erstellung von Berichten verwendet werden können. Web-Crawling wird häufig für die Marktforschung und Wettbewerbsanalyse eingesetzt, während Daten-Crawling dazu dient, interne Unternehmensdaten zu sammeln und zu analysieren. **
-
Was sind die potenziellen Vor- und Nachteile von Web-Crawling für die Datenbeschaffung im Internet?
Potenzielle Vorteile von Web-Crawling sind die schnelle und automatisierte Datenbeschaffung, die Möglichkeit, große Mengen an Informationen zu sammeln und die Fähigkeit, Daten aus verschiedenen Quellen zu kombinieren. Nachteile könnten rechtliche Probleme aufgrund von Urheberrechtsverletzungen, ungenaue oder veraltete Daten sowie die Möglichkeit von Fehlern bei der Extraktion und Interpretation der Informationen sein. Es ist wichtig, ethische Richtlinien zu beachten und sicherzustellen, dass die Daten auf legale Weise gesammelt und verwendet werden. **
-
Was sind die Vorteile von Web-Crawling für die Datenextraktion?
Web-Crawling ermöglicht die automatische Extraktion von großen Mengen an Daten aus dem Internet. Es spart Zeit und Ressourcen, da Informationen schnell und effizient gesammelt werden können. Zudem können mithilfe von Web-Crawling aktuelle und relevante Daten für Analysen und Entscheidungsfindungen gewonnen werden. **


Wie unterscheidet sich Web-Crawling von Web-Scraping und welche rechtlichen Aspekte sind dabei zu beachten? In welchen Fällen ist es ethisch vertretbar, Web-Crawling für die Extraktion von Daten aus dem Internet zu verwenden?
Web-Crawling bezieht sich auf das automatisierte Durchsuchen des Internets nach Inhalten, während Web-Scraping das Extrahieren und Speichern dieser Daten bezeichnet. Beim Web-Crawling müssen die Robots.txt-Dateien und die Nutzungsbedingungen der Website beachtet werden, um rechtliche Probleme zu vermeiden. Es ist ethisch vertretbar, Web-Crawling für Forschungszwecke, zur Verbesserung von Suchmaschinen oder zur Datensammlung für öffentliche Interessen zu verwenden. **
Wie werden Web-Crawling-Tools verwendet, um Daten aus dem Internet zu extrahieren und zu analysieren?
Web-Crawling-Tools durchsuchen automatisch das Internet nach bestimmten Inhalten, indem sie Websites nach Links und Informationen scannen. Die extrahierten Daten werden dann gesammelt und in einer strukturierten Form gespeichert. Anschließend können diese Daten analysiert werden, um Trends, Muster oder Informationen zu identifizieren. **
Top-Angebote
Produkte zum Begriff Wyrd---Crawling-Chaos:
-
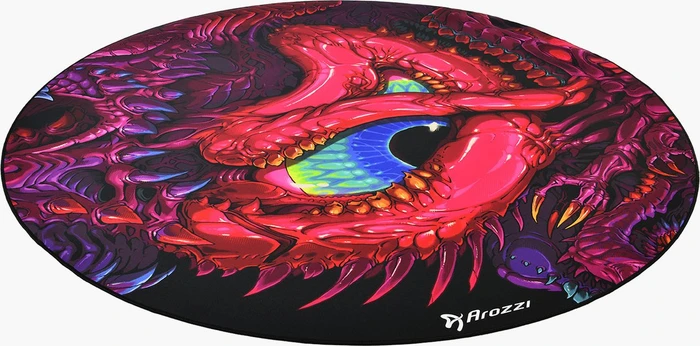
Arozzi Zona Floor Pad Crawling ChaosBodenschutzmatte - für harte Fußböden, aus Gummi, Abmessungen: 121 × 121 cm (L×B), rund, Farbe: schwarz und rosa Sie verbringen viele Stunden in einem Sessel auf Rädern am Computer und wollen keine weiteren Rillen in Ihrem Fußbodenbelag hinterlassen? Zur Lösung dieses Problems empfiehlt sich eine Bodenschutzmatt55,90 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
Wie beeinflusst das Crawling von Suchmaschinen die Sichtbarkeit einer Website im Internet?
Das Crawling von Suchmaschinen ermöglicht es, dass die Inhalte einer Website indexiert werden und in den Suchergebnissen erscheinen. Je häufiger eine Website gecrawlt wird, desto schneller werden neue Inhalte entdeckt und in den Suchergebnissen angezeigt. Eine regelmäßige Optimierung der Website für Suchmaschinen kann die Sichtbarkeit und das Ranking in den Suchergebnissen verbessern. **
-
Was sind die Vor- und Nachteile von Web-Crawling für die Datensammlung im Internet?
Vorteile: Web-Crawling ermöglicht eine schnelle und automatisierte Datensammlung im Internet, was Zeit und Ressourcen spart. Es können große Mengen an Daten in kurzer Zeit gesammelt werden. Nachteile: Es kann zu rechtlichen Problemen kommen, da nicht alle Websites das Crawlen ihrer Daten erlauben. Zudem können veraltete oder ungenaue Informationen gesammelt werden, da Web-Crawler nicht immer die aktuellsten Daten liefern. Schließlich kann die Qualität der gesammelten Daten aufgrund von Fehlern im Crawling-Prozess beeinträchtigt werden. **
-
Wie können Web-Crawling-Technologien genutzt werden, um Informationen aus dem Internet zu extrahieren und zu analysieren? Welche Vorteile bietet Web-Crawling bei der Sammlung von Daten aus dem World Wide Web?
Web-Crawling-Technologien durchsuchen automatisch das Internet nach relevanten Informationen, extrahieren diese und speichern sie in einer Datenbank. Durch die kontinuierliche Aktualisierung der gesammelten Daten können Trends und Muster identifiziert und analysiert werden. Dies ermöglicht Unternehmen, fundierte Entscheidungen auf der Grundlage aktueller Informationen zu treffen und Wettbewerbsvorteile zu erlangen. **
-
Was sind die Unterschiede zwischen Web-Crawling und Daten-Crawling und wie werden sie in der Datenanalyse eingesetzt?
Web-Crawling bezieht sich auf das Durchsuchen von Websites im Internet, um Informationen zu sammeln, während Daten-Crawling sich auf das Durchsuchen von strukturierten Datenquellen wie Datenbanken oder APIs bezieht. In der Datenanalyse werden Web-Crawling und Daten-Crawling eingesetzt, um relevante Daten zu sammeln und zu extrahieren, die dann für die Analyse und Erstellung von Berichten verwendet werden können. Web-Crawling wird häufig für die Marktforschung und Wettbewerbsanalyse eingesetzt, während Daten-Crawling dazu dient, interne Unternehmensdaten zu sammeln und zu analysieren. **
Ähnliche Suchbegriffe für Wyrd---Crawling-Chaos
-
Was sind die potenziellen Vor- und Nachteile von Web-Crawling für die Datenbeschaffung im Internet?
Potenzielle Vorteile von Web-Crawling sind die schnelle und automatisierte Datenbeschaffung, die Möglichkeit, große Mengen an Informationen zu sammeln und die Fähigkeit, Daten aus verschiedenen Quellen zu kombinieren. Nachteile könnten rechtliche Probleme aufgrund von Urheberrechtsverletzungen, ungenaue oder veraltete Daten sowie die Möglichkeit von Fehlern bei der Extraktion und Interpretation der Informationen sein. Es ist wichtig, ethische Richtlinien zu beachten und sicherzustellen, dass die Daten auf legale Weise gesammelt und verwendet werden. **
-
Was sind die Vorteile von Web-Crawling für die Datenextraktion?
Web-Crawling ermöglicht die automatische Extraktion von großen Mengen an Daten aus dem Internet. Es spart Zeit und Ressourcen, da Informationen schnell und effizient gesammelt werden können. Zudem können mithilfe von Web-Crawling aktuelle und relevante Daten für Analysen und Entscheidungsfindungen gewonnen werden. **
-
Wie unterscheidet sich Web-Crawling von Web-Scraping und welche rechtlichen Aspekte sind dabei zu beachten? In welchen Fällen ist es ethisch vertretbar, Web-Crawling für die Extraktion von Daten aus dem Internet zu verwenden?
Web-Crawling bezieht sich auf das automatisierte Durchsuchen des Internets nach Inhalten, während Web-Scraping das Extrahieren und Speichern dieser Daten bezeichnet. Beim Web-Crawling müssen die Robots.txt-Dateien und die Nutzungsbedingungen der Website beachtet werden, um rechtliche Probleme zu vermeiden. Es ist ethisch vertretbar, Web-Crawling für Forschungszwecke, zur Verbesserung von Suchmaschinen oder zur Datensammlung für öffentliche Interessen zu verwenden. **
-
Wie werden Web-Crawling-Tools verwendet, um Daten aus dem Internet zu extrahieren und zu analysieren?
Web-Crawling-Tools durchsuchen automatisch das Internet nach bestimmten Inhalten, indem sie Websites nach Links und Informationen scannen. Die extrahierten Daten werden dann gesammelt und in einer strukturierten Form gespeichert. Anschließend können diese Daten analysiert werden, um Trends, Muster oder Informationen zu identifizieren. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.